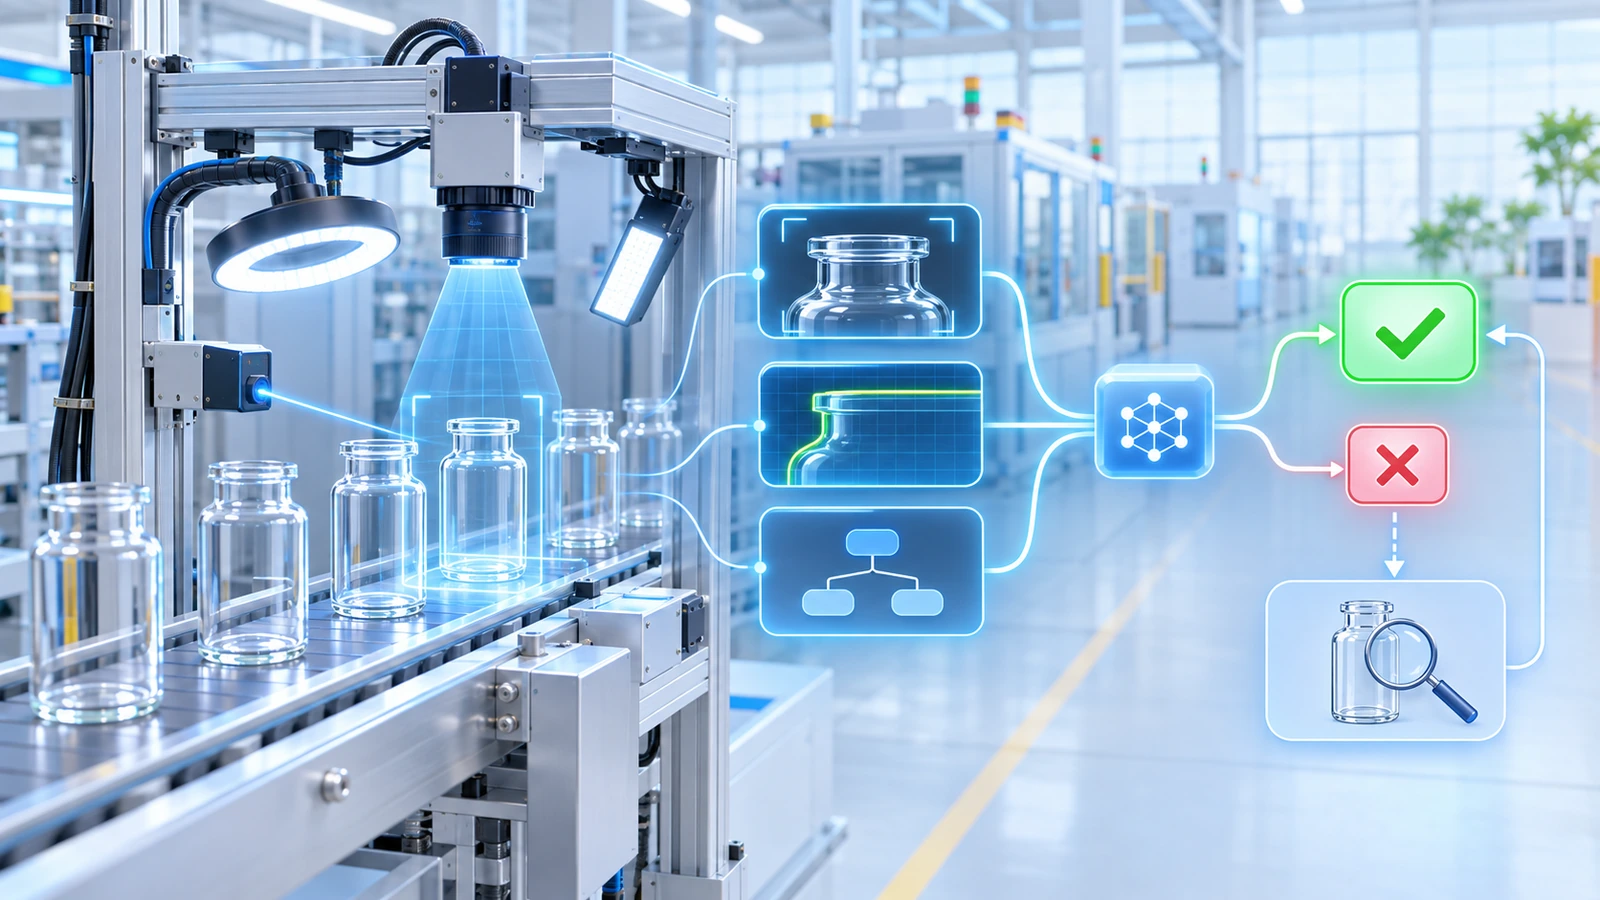
结论先说:工业视觉质检不应把一个大模型、一个异常分数或一条“合格/不合格”结论当作完整验收证据。更稳妥的系统要把稳定成像、确定性图像信号、模型语义判断、业务规则、专家标签与人工复核分开记录,再用已验证的融合逻辑形成最终判定。11月5日,AWS公开一套电商内容质量评估方法:完整页面先交给视觉语言模型理解,再补OCR可读性信号,用专家共识标签训练轻量分类器,并用特征归因解释为什么判低。这不是工业缺陷检测案例,但它清楚展示了“单一模型分数不够”的工程方法。
本轮优先核验北京时间执行前24小时的一手材料,并向前扩展到48小时。合格更新集中在2026年11月4日至5日,覆盖视觉质量评估、智能体评分器、审批控制、显存复用、计算架构、数据智能体可观测与开发安全。没有把媒体转述、榜单或Star数作为采购依据。
今日重点
- 视觉质量评估从单模型走向多信号融合。 AWS把完整商品页面渲染成快照,用VLM判断整体语义和布局,再加入OCR得到的文字密度、字符密度、间距和可读性。已核验的是Amazon A+ Content方法;未知的是迁移到制造缺陷后需要哪些光学、工艺与停线信号。视觉项目负责人应关注方法,不应照搬指标。
- 专家标签用于校准通用模型。 公开实验中,5,478个页面由一名电商营销专家和四名专业标注员独立评分,以多数票形成共识标签;轻量分类器学习VLM与OCR信号如何组合。它说明通用模型的评分要对齐本企业质量口径,而不是直接把提示词输出当标准答案。
- 解释能力要能指出下一步修什么。 AWS使用SHAP识别哪些特征推动了低质量判断,再把负向因素转成改进建议。对工业视觉而言,可迁移的是“缺陷结论必须带证据位置、成像状态、规则版本和复核优先级”;不能把电商页面的特征重要性变成玻璃瓶阈值。
- 窄问题可用小型决策模型先筛查。 AWS在11月4日介绍把固定选项、校准概率的决策模型接入AgentCore评估,并明确它适合“是否有依据”“是否完成目标”等窄问题,不能替代需要解释的通用评估。质量系统也应把可精确计算、可固定选择和需专家判断的项目分层。
- 自动审批仍由策略决定边界。 Amazon Quick的Smart Approvals只审核策略允许自动复核的精确动作和参数;强制人工审批与拒绝策略继续生效,执行是否完成还要看目标系统记录。制造现场的自动剔除、停机和参数写入更不能只凭模型置信度放行。
- 显存采购开始看每字节有效工作量。 NVIDIA把权重精度、专家并行、KV缓存路由、CPU内存与共享存储放在同一协同设计中。厂商数字只适用于特定平台和基准;私有化项目应按真实并发、上下文、延迟与质量回归测试,而不是只比较显存容量。
- 算力也要按工作负载分层验。 微软在Cobalt 200上分别测数字仿真、模拟仿真、物理验证和静态时序,并在脚注限定版本、配置、并发与测试条件。对视觉项目的启示是:采图、预处理、推理、后处理与归档的瓶颈不同,一个平均FPS不能替代端到端节拍。
- 数据智能体可观测继续覆盖轨迹、延迟和成本。 Google 11月5日汇总BigQuery数据智能体的性能、采用、延迟、成本和多轮执行轨迹可观测能力。它与视觉质检共同提醒企业:上线后要能看见输入分布、判定链、人工复核和资源消耗,而不是只保存最终答案或最终剔除数。
重点拆解:为什么一个模型分数不够
单一分数会把性质不同的问题混在一起。相机失焦、曝光漂移和玻璃反光属于成像问题;缺陷特征超出训练覆盖属于模型边界;不同瓶型阈值混用属于配置问题;剔除未执行或工件追踪错位属于控制问题。它们都可能表现为“误检”或“漏检”,但整改责任完全不同。
因此,采购和验收应先拆成五层证据:
- 成像层。 记录相机、镜头、光源、曝光、视野、触发、工件姿态与图像质量。成像不合格时,模型结果只能标为不可判定,不能继续输出高置信结论。
- 确定性信号层。 对清晰度、亮度、过曝区域、遮挡、位置偏移、轮廓完整性等可计算项目使用规则或传统视觉。它们可重复、易解释,也适合做前置门。
- 模型判断层。 异常检测、监督模型或VLM输出缺陷类别、位置、分数与版本。模型负责处理规则难覆盖的变化,但不能替代图像质量检查。
- 业务决策层。 按瓶型、区域、缺陷等级、节拍和后果组合阈值,决定放行、复核、剔除、报警或停机。模型分数在这里才被解释成业务动作。
- 终态与反馈层。 保存人工复核、剔除确认、返修结果、误检漏检归因和样本回流。没有终态,系统无法证明动作发生,也无法知道下一版该修模型还是修光学。
AWS案例用OCR补VLM,原因不是“OCR比大模型更先进”,而是两类信号看到的问题不同。工业视觉同理:清晰度、曝光和几何位置最好由确定性算法把关;纹理异常、未知缺陷或跨区域语义再交给模型;最终决策由业务规则与终态证据闭环。技术越复杂,越需要让每层只承担它擅长的问题。
如何校准,而不是迷信置信度
模型输出0.92,不代表现场就有92%的正确概率。分数是否可解释,取决于训练分布、类别不平衡、瓶型变化、光学条件和阈值校准。更稳妥的做法是:从真实生产按瓶型、缺陷、区域、班次和工况分层抽样;由至少两名有质量职责的人独立复核争议样本;保留未参与训练和调参的留出集;再比较单一模型、确定性信号和融合判定在同一留出集上的误检、漏检与不可判定。
这里可以借鉴AWS的“固定大模型、训练轻量分类器”思路,但不能默认一定是最佳方案。样本少、规则清晰时,直接写业务规则更可靠;类别多且语义复杂时,轻量校准器可学习不同信号的权重;高风险缺陷仍应设置独立硬规则或人工复核。任何融合器上线前都要回答三件事:标签是否代表真实质量口径;分数在不同瓶型和班次是否稳定;失败时能否退回保守路径。
一张可执行的验收表
| 验收对象 | 必留证据 | 通过条件 | 失败后先查 | |---|---|---|---| | 成像 | 原图、相机与光源参数、触发时间 | 视野、清晰度、曝光与姿态在约定范围 | 光学、安装、触发与工装 | | 确定性信号 | 清晰度、亮度、遮挡、位置等数值 | 同输入可重复,阈值和单位有版本 | 预处理与规则版本 | | 模型 | 版本、输入、缺陷位置、类别与分数 | 留出集上按缺陷和工况达标 | 数据覆盖、标注与漂移 | | 融合决策 | 信号组合、阈值、瓶型模板 | 每次判定能还原为何放行或拦截 | 配置、校准器与规则冲突 | | 产线动作 | 工件ID、剔除/报警命令与回执 | 动作完成且与目标工件一致 | 通信、队列、追踪与机构 | | 人工复核 | 复核人、终态、原因与时间 | 争议样本有闭环并可回流 | 质量口径与复核负担 |
验收不要只报总体准确率。至少按关键缺陷召回、良品误剔、不可判定率、每小时人工复核量、P95端到端时延、剔除确认率和连续运行稳定性分层记录。阈值应由企业对漏检、误剔、停线和人工成本的权衡确定;本文不给未经现场核定的固定数字。
白泽公开的玻璃瓶自学习缺陷检测案例可用于核验多视角成像、正常样本建模与瓶型模板的项目边界;工业视觉质检解决方案说明从成像、算法到产线集成的承接范围;视觉检测验收样本怎么设计提供冻结样本与工况分层方法。上述页面不代表已实测AWS方案,也不提供未公开的准确率、报价或收益。
适用条件与风险
多信号融合适合透明反光、多曲面、换型频繁、缺陷长尾且误剔漏检后果不同的场景。若产品稳定、缺陷形态固定、线速较低,规则视觉加人工抽检可能更经济。不要为了“用了大模型”增加不可解释环节;也不要把规则可解决的问题都交给VLM。
主要风险包括:标注共识掩盖少数但高风险缺陷;训练和验收样本相邻帧泄漏;融合器在新瓶型上仍输出高置信;图像质量不合格却没有不可判定状态;人工复核队列积压;自动剔除未校验工件身份;上线后只记录最终标签,无法追责到成像、模型或控制层。每项都应有停用自动动作、转人工和回滚版本的路径。
今日企业行动
- 从现有视觉系统抽取最近一周误检和漏检,各选10至20个样本,先按成像、规则、模型、配置、控制和复核六类归因,不急着调模型。
- 把“清晰度、曝光、遮挡、姿态”等可计算信号从模型分数中拆出,明确哪些失败必须进入不可判定或人工复核。
- 用同一留出集对比单模型与融合判定,逐项记录关键缺陷、良品误剔、复核量、P95时延和剔除终态;缺失数据保留为空,不用估算填满。
准备咨询时,可提供脱敏原图、瓶型或产品清单、缺陷定义、最小缺陷尺度、线速与节拍、相机和光源配置、现有误检漏检样本、剔除接口及人工复核流程。白泽智能|重庆斯巴达信息技术有限公司。
来源与证据边界
- AWS:Amazon Marketplace内容质量多信号评估(2026-11-05)
- AWS:AgentCore决策模型评估(2026-11-04)
- AWS:Amazon Quick智能审批(2026-11-04)
- NVIDIA:AI工厂每字节有效工作量(2026-11-05)
- Microsoft Azure:Cobalt 200上的EDA工作负载(2026-11-05)
- Google Cloud:Data Cloud更新(2026-11-05)
- GitHub:密钥检测器降低误报(2026-11-05)
- Google Cloud:Agentic Data Cloud(2026-11-04)
厂商实验、内部基准和产品预览只按原始适用范围陈述,不作为白泽工业视觉成绩、报价或收益承诺。未取得实时搜索量、热搜、站长查询或需求规模。