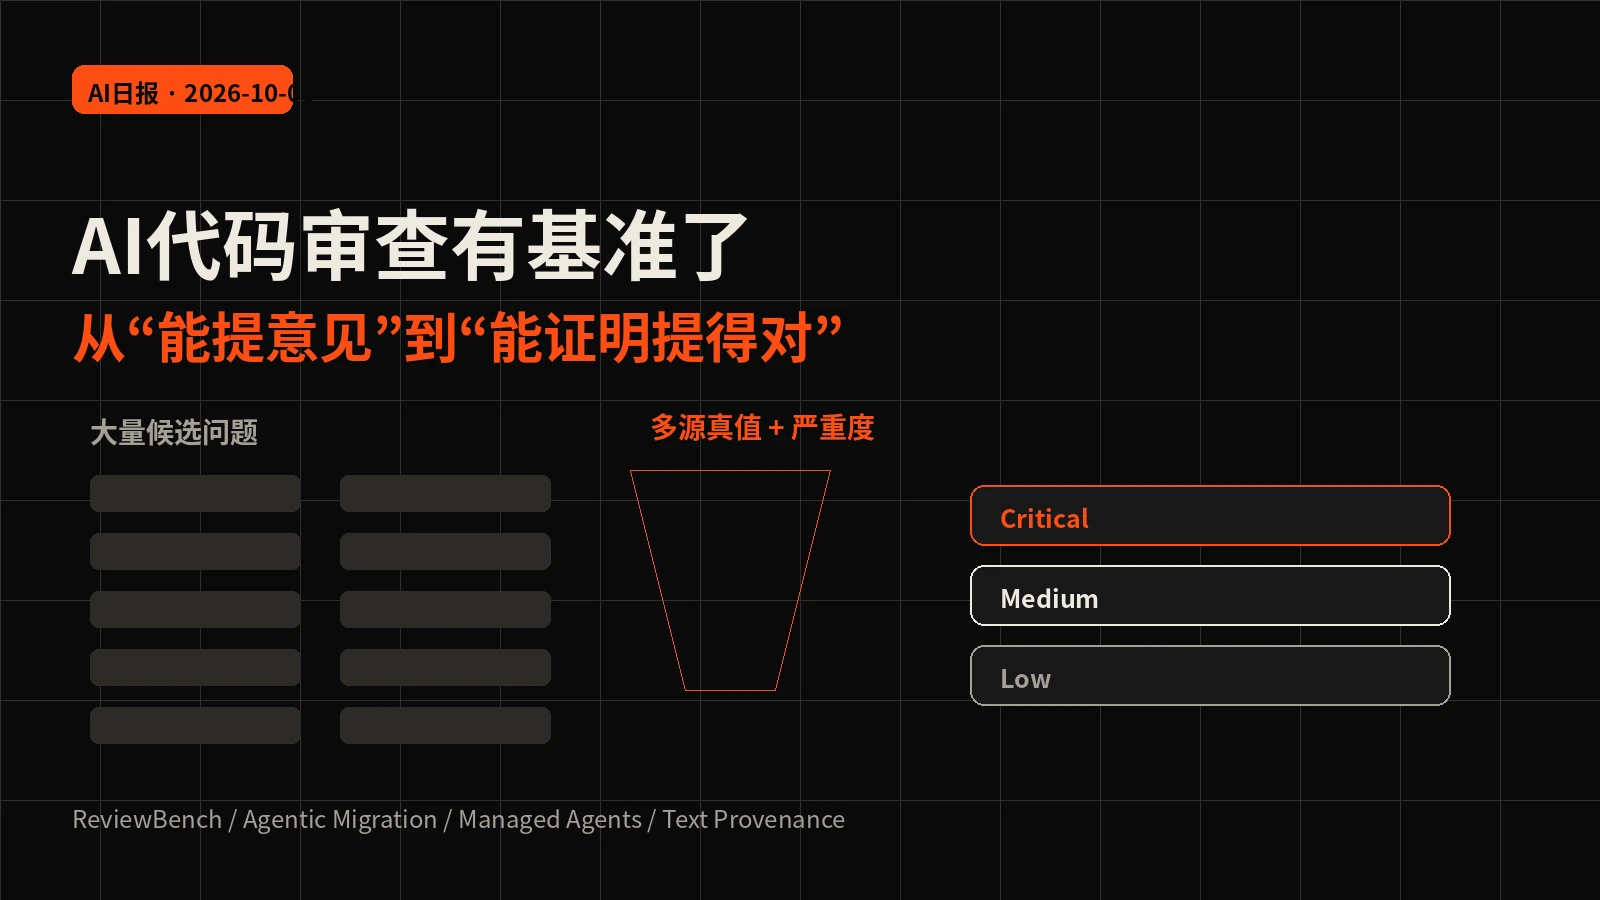
过去24小时的一手更新显示,企业AI开始把评测、迁移、身份治理和内容追溯写进工程控制层。白泽重点拆解ReviewBench的代表性任务、多源真值、严重度分层与线上验证。
今日重点
- GitHub在10月5日发布ReviewBench,用代表性Pull Request、多源黄金集和统一评分方法评测AI代码审查Agent。
- GitHub称其先分析了1.039亿个Pull Request的语言、仓库规模和变更形态,再构造219个公开PR、覆盖19种语言的评测集。
- ReviewBench的黄金真值来自人工评审、前沿模型和静态分析,并由高级工程师独立审计;官方报告黄金真阳性标签一致率为96.6%。
- Google Cloud 10月5日推出Google Cloud Modernize;EKS-to-GKE Agentic Migration处于Public Preview,包含Human-in-the-Loop批准门和内存凭据保护。
- AWS 10月5日周报确认Amazon Bedrock Managed Agents powered by OpenAI处于Public Preview,可在AWS身份、权限和治理体系内运行。
- OpenAI 10月5日开放API文本水印选择功能;未来数周将在欧盟为符合条件的ChatGPT和Codex文本输出加入不可见水印。
- OpenAI同时明确文本水印存在漏检和误报边界,因此检测器初期只向批准的研究者和专家组织开放。
- Google 10月5日的教学案例允许学生用Gemini生成和修改代码,但最终通过口头答辩解释选择、排查问题,并指出AI建议可能出错的位置。
窗口说明:本轮以2026-10-05至2026-10-06的一手材料为主。公开热搜排名、搜索指数和平台流量未取得,因此没有把“热度”写成事实。
1. GitHub把AI代码审查推进到生产型评测
ReviewBench的价值不在于多一个排行榜,而在评测方法。GitHub先分析1.039亿个Pull Request的分布,再从187个公开开源仓库选取219个PR,覆盖19种语言。样本并非只追求最常见的小改动,而是适当增加更有审查价值的中大型变更。
黄金集也没有只让一个模型打标签。GitHub把人工评审、前沿模型和静态分析发现合并,再用统一rubric和高级工程师审计建立真值。官方披露,发布前对黄金真阳性进行独立标注时达到96.6%一致率。
对企业研发团队而言,这意味着“AI审查有效”不能只看评论数量。至少要拆成严重度、类别、precision、recall,并区分安全、正确性、可靠性、可维护性和测试问题。一个高召回但低精度的Agent,可能让团队每天多处理大量无效意见;一个过于保守的Agent又可能漏掉关键风险。
2. Google Cloud让迁移Agent自动做事,但仍保留批准门
Google Cloud Modernize把基础设施评估、平台迁移和应用现代化整合到一个组合中。对工程团队最有参考价值的是EKS-to-GKE Agentic Migration:它自动做发现、Kubernetes清单转换、存储和网络映射,同时保留Human-in-the-Loop批准门与内存凭据安全。
这说明生产Agent的默认形态正在从“生成建议”转向“生成动作+受控执行”。自动化可以完成大量机械步骤,但跨云迁移会触碰网络、存储、身份、配置和生产流量,任何一个错误都可能扩大成停机或数据问题。
企业内部做MES、ERP、IoT平台或边缘节点迁移时也适用同一原则:让Agent负责扫描、映射、生成变更计划和候选配置;真正写入生产之前,必须经过差异审查、权限检查和可回滚确认。
3. AWS把OpenAI Agent接入已有身份和治理体系
AWS在10月5日周报确认,Amazon Bedrock Managed Agents powered by OpenAI处于Public Preview。官方描述强调,它基于定制的OpenAI Agents API,并针对AWS原生环境做集成,让Agent在既有身份、权限和治理控制下运行。
企业真正需要关注的是“控制面复用”。如果新Agent平台要重新做一套身份、凭据、日志和权限系统,生产上线会变慢,也容易出现平行治理。能复用已有IAM、运行时隔离和审计机制,才更接近可运营状态。
这并不意味着托管Agent自动满足企业合规。团队仍需要明确哪些模型可用、哪些资源允许访问、会话数据如何保存、失败怎样恢复,以及第三方工具调用是否进入同一审计链。
4. OpenAI开放文本水印:可追溯信号有用,但不能当真伪判决器
OpenAI 10月5日宣布,全球API客户可以为部分模型选择开启文本水印;未来数周将在欧盟对符合条件的ChatGPT和Codex文本输出加入不可见水印。它服务于文本来源透明与欧盟AI规则要求。
更重要的是边界声明:OpenAI明确指出,水印检测会有漏检和误报风险,检测器因此没有直接向公众开放,而是先给批准的研究者和专家组织。这提醒企业,内容来源识别应该是“信号”,不是单一判决。
企业如果需要追溯AI生成内容,更稳妥的办法是同时保存生成系统、模型版本、时间、业务对象、审批人和内容哈希。水印可以补充来源判断,但不能替代内部审计记录。
5. AI使用者的考核重点转向判断与解释
Google 10月5日发布的教育案例里,学生可以用Gemini在Colab中协作完成数据挖掘任务,但最后要通过口头答辩解释选择、排查问题,并指出AI建议可能错误的地方。
这不是企业人才标准,却很适合迁移到内部培训:让员工用AI完成任务没有问题,验收时要求其说明输入限制、关键假设、验证方法和停止条件。对研发、售前、项目和运营岗位而言,这比“会不会写提示词”更接近实际责任。
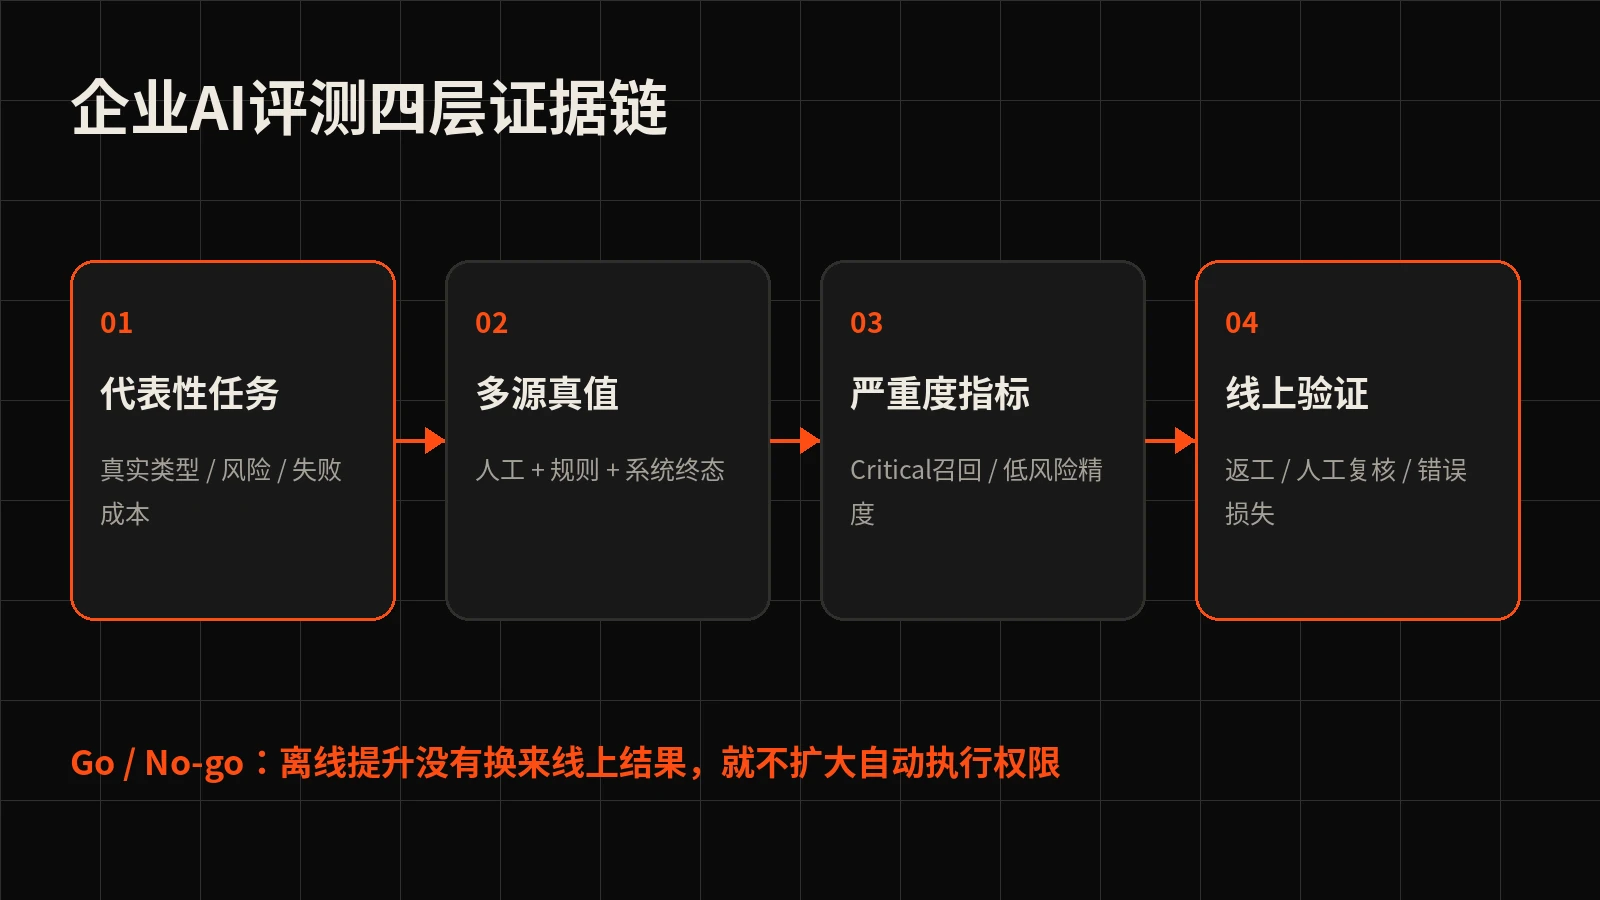
白泽重点拆解:企业AI评测要补四层证据
第一层:代表性任务。不要用十个精心挑选的Demo做评测。先统计真实任务的类型、规模、频次和失败成本,再按分布抽样。工业视觉要覆盖正常品、典型缺陷、边界缺陷、光照变化和设备漂移;Agent要覆盖正常流程、权限不足、超时、重复事件和部分成功。
第二层:多源真值。真值不能完全由同一个模型生成。至少组合人工确认、规则/静态检查和可执行结果。能够落到数据库、MES、ERP、工单或设备状态的任务,优先用确定性状态做验证。
第三层:按严重度和类别看指标。总准确率会隐藏风险。生产更关心Critical问题的召回、低风险提示的精度、误报带来的人工成本,以及不同类别的性能差异。
第四层:离线分数必须回到线上验证。GitHub特别强调ReviewBench的离线变化会与生产实验方向对照。企业也应该用真实小流量验证:评测集分数提高以后,人工复核是否减少、返工是否下降、漏检损失是否变小。没有线上结果,就不能把离线提升直接写成ROI。
仍未知的边界
- ReviewBench聚焦代码审查,不代表所有Agent任务都适用同一数据集和权重。
- Google Cloud迁移Agent处于Public Preview,企业生产可用性还要结合区域、权限和自身架构验证。
- AWS Managed Agents powered by OpenAI同样处于Public Preview,正式SLA、成本和支持边界需要以实际账户文档为准。
- 文本水印只能提供来源信号,不能证明内容真实、正确,也不能覆盖所有模型和历史文本。
今日企业行动清单
- 从一个AI流程抽取30–50个真实任务,按类型、风险和失败成本分层,不再只用Demo验收。
- 为每个任务建立“人工/规则/系统终态”至少两类真值来源,并分别统计Critical问题的召回与低风险提示的精度。
- 任何AI生成内容或自动执行结果进入业务前,保留模型版本、审批人、业务对象、结果哈希与回滚记录;无法追溯的流程先保持人工确认。
FAQ
ReviewBench最值得企业复制的是什么?
代表性样本、多源真值、严重度分层和离线到线上验证,而不是直接复制它的代码审查数据集。
Agent迁移为什么还需要Human-in-the-Loop?
迁移会修改生产配置、网络、存储和权限。批准门可以把自动生成的计划与最终执行责任分开,并保留回滚点。
文本水印能证明一段文字由AI生成吗?
不能作为绝对证明。官方明确存在漏检和误报边界,更适合作为来源信号,与内部日志和内容哈希一起使用。
白泽能协助哪些环节?
白泽可围绕重庆AI开发、RAG研发、Agent、工业视觉、边缘计算与系统集成,帮助企业建立任务集、真值、评测指标、权限门和受控执行链路。