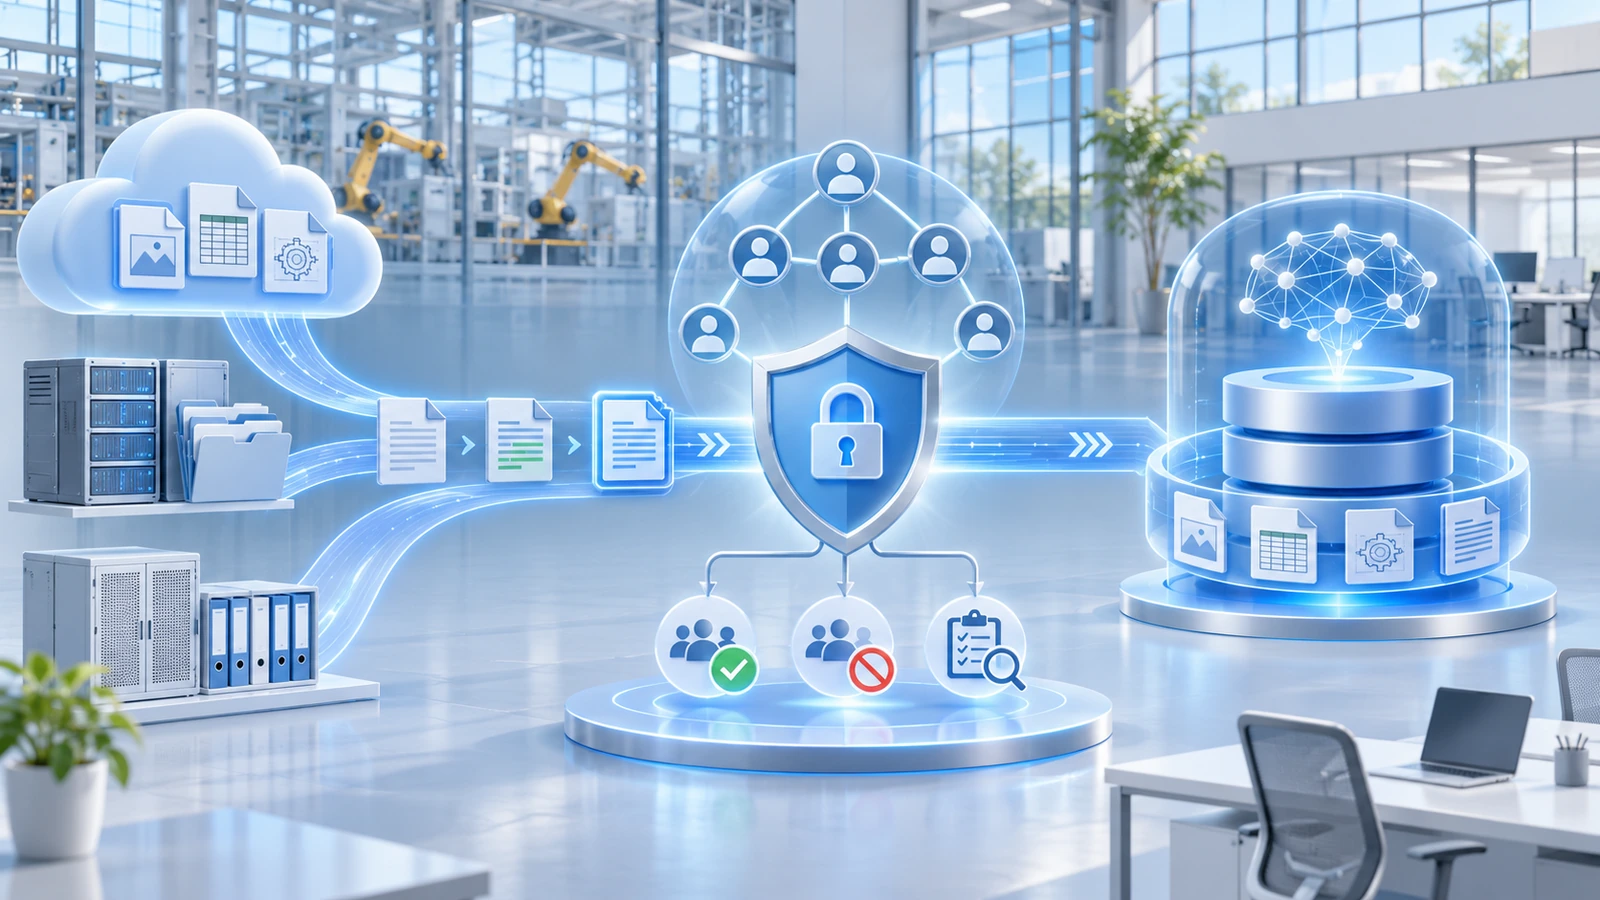
企业知识库同步文档和权限,建议采用“首次全量快照 + 持续增量事件 + 周期性对账”的混合方式。正文、版本、删除状态和访问控制列表必须沿同一条同步链处理;检索时还要按当前用户身份做权限过滤。只把文件内容写进向量库、再另做一张静态权限表,迟早会出现旧文件仍可回答、人员撤权后仍能检索、移动目录后继承关系错误等问题。
这套方法适合接入网盘、SharePoint、Confluence、文件服务器、业务系统附件和数据库知识的企业RAG。若资料没有稳定ID、人员身份没有统一目录、源系统无法提供变更记录,应先补数据与身份治理,不宜直接承诺“实时同步”。

一、同步的不是文件,而是一个可回放状态
一条可进入企业知识库的记录,至少要包含以下字段。字段名可按系统调整,但语义不能缺失。
| 同步对象 | 最少记录 | 为什么需要 |
|---|---|---|
| 内容身份 | source、source_item_id、parent_id、path | 文件改名或移动后仍能识别同一个对象 |
| 内容版本 | source_version、modified_at、content_hash | 判断是否需要重切分、重建向量和回滚 |
| 生命周期 | active、deleted、archived、effective_at | 撤下文件不能继续被旧索引召回 |
| 权限主体 | user_id、group_id、domain、role | 把源系统用户和企业统一身份对应起来 |
| 权限来源 | direct、inherited、inherited_from | 目录继承变化时知道应重算哪些子项 |
| 同步进度 | cursor、event_id、indexed_at、index_version | 支持断点续跑、幂等和问题回放 |
白泽的判断是:内容状态与权限状态必须使用同一版本号或同一批次号提交。如果正文先更新、权限晚几分钟才到,检索层就可能短暂暴露新内容;如果权限先收紧、旧向量仍在可检索集合中,也会留下越权窗口。生产系统应优先执行删除和撤权,再处理新增和放权。
二、三种同步方式怎么选
| 方式 | 适用条件 | 优点 | 主要风险 |
|---|---|---|---|
| 定时全量扫描 | 资料量小、接口弱、更新不频繁 | 实现简单,容易核对总量 | 成本高、延迟大,扫描期间容易漏掉并发变化 |
| Webhook或变更游标 | 源系统提供稳定事件、delta或changes接口 | 延迟低,只处理发生变化的对象 | 事件可能重复、乱序或丢失,必须做幂等和补偿 |
| 混合方式 | 大多数生产知识库 | 增量保证时效,对账保证完整 | 设计稍复杂,需要状态表和失败队列 |
微软Graph的driveItem delta要求先完成分页枚举,再保存deltaLink用于后续变化;删除项会带deleted标记。Google Drive的changes集合同样通过page token持续读取当前状态。两类接口都说明了一件事:同步器必须保存游标并处理分页、重复、删除和恢复,不能把“每隔几分钟重新抓列表”当成可靠增量同步。
对没有原生事件的文件服务器,可以用目录快照加内容哈希;但仍要为文件生成稳定ID,并把重命名、移动、删除与新建区分开。若只能看到最终目录而看不到变更历史,就应明确同步时效和误差边界。
三、权限同步要先解决身份映射
源系统里的权限主体可能是个人、部门群组、项目组、域用户、外部协作者或公开链接。知识库不能直接把显示名称当身份键,而应建立稳定映射:源系统principal_id对应企业user_id或group_id,并记录映射版本、有效期和来源。
权限计算建议分四步:
- 采集直接权限与继承关系。保存某项权限来自文件本身、父目录、站点还是共享盘。
- 展开群组成员。群组变化也要进入增量链,离职、调岗和项目组解散需要触发撤权。
- 生成检索过滤条件。每个切片继承文档级ACL,检索前按当前用户与群组过滤,禁止先召回敏感内容再让大模型“自觉不回答”。
- 拒绝优先。身份映射失败、权限数据过期或源系统不可达时,敏感库默认不返回,而不是沿用未知状态。
Google Drive官方文档明确区分直接权限和继承权限,并提供inheritedFrom等来源信息;文件移动后还会重新按新父级计算权限。Confluence也把站点、空间和内容限制共同纳入权限检查。这意味着权限同步不是复制一个reader/writer字段,而是复现源系统的判定路径。
四、三种检索权限模型的取舍
| 模型 | 做法 | 适合 | 不适合 |
|---|---|---|---|
| 统一索引 + 检索前ACL过滤 | 所有切片在同一索引,查询时带用户/群组条件 | 权限规则可结构化、规模中等的大多数项目 | 身份字段缺失或过滤能力弱的向量服务 |
| 按安全域隔离索引 | 部门、项目或密级分别建索引 | 边界稳定、强隔离要求 | 安全域数量多、跨域查询频繁的场景 |
| 检索后再过滤 | 先召回再剔除无权结果 | 仅可作为二次校验 | 不能作为主方案,可能暴露标题、摘要、分数或缓存 |
多数企业知识库可以采用“安全域隔离 + 域内ACL过滤”的组合:涉密、财务、人事等先分域,域内再按用户和群组过滤。所有缓存键还要包含身份和权限版本,避免A用户的检索结果被B用户命中。
五、实施建议分六步
第一步:冻结范围与源系统责任
先列出资料源、负责人、稳定ID、版本字段、删除语义、权限来源、接口限额和允许同步的内容类型。不要从“把所有文件接进来”开始,应先选一个业务场景和一到两个资料源。
第二步:建立首次全量快照
全量阶段要记录开始游标或基准时刻,再分页读取对象和权限。扫描期间发生的变化不能丢;完成快照后,立即从基准游标继续消费增量。全量数量、失败数量和权限缺失数量都要有对账表。
第三步:建设幂等增量流水线
同一event_id重复到达不重复写入;同一source_item_id只接受更新版本;失败进入可重放队列。内容解析、切片、Embedding和索引写入应分阶段记录状态,不能用一个“同步成功”掩盖中间失败。
第四步:把撤权和删除设为高优先级
人员撤权、群组移除、文件删除或密级提高时,先把对象从可检索集合中隔离,再异步清理向量和缓存。新增、放权可以排队,撤权不能等待大批量重建完成。
第五步:使用版本化索引发布
大规模重切分或更换Embedding时,不要原地覆盖生产索引。新版本在影子索引构建并完成样本回放,通过后切换别名;保留上一个可用版本和游标,才能快速回滚。
第六步:小范围灰度再扩源
先用一个部门、两类角色和一组脱敏问题验证。灰度通过后再增加资料源和人群。每次扩源都重新核对身份、继承、删除和接口限额,而不是只看新增文档数。
六、项目开始前要准备什么
| 责任方 | 需要准备的输入 | 交付输出 |
|---|---|---|
| 业务部门 | 典型问题、权威资料、失效规则、责任人 | 场景范围与内容白名单 |
| IT/身份团队 | 用户目录、群组、SSO、离职调岗流程 | 身份映射与撤权链路 |
| 源系统管理员 | API、事件、版本、删除和权限说明 | 连接器参数与限额清单 |
| 知识库实施方 | 解析、切片、索引、过滤、监控方案 | 同步服务、版本索引、失败队列与验收报告 |
周期和费用不能只按文档数量估计。决定实施量的因素包括源系统数量、历史资料质量、权限层级、群组规模、更新频率、接口限额、是否要求近实时、是否需要私有化,以及验收样本是否已准备。本文不给未经现场核定的固定工期或报价。
七、验收不要只看“能搜到”
建议至少覆盖以下七组测试,并由企业在立项时确定目标值:
- 新增时效:新文件在约定窗口内进入检索,且引用指向正确版本。
- 修改一致性:正文更新后旧切片不再参与回答,历史版本仍可审计。
- 删除与撤权:文件删除、人员离职、群组移除后立即或在约定窗口内不可检索,缓存同时失效。
- 继承变化:父目录权限、有限访问文件夹和项目组变化能正确影响子项。
- 移动重命名:对象身份保持稳定,不产生重复文档,权限按新位置重算。
- 故障恢复:接口限流、网络中断、解析失败后可从游标续跑,不漏项、不重复。
- 审计回放:任一答案可追到用户身份版本、文档版本、权限判断、检索结果和索引版本。
验收集要包含正向用户、无权用户、刚撤权用户、跨群组用户和身份映射失败用户。越权不是“准确率的一部分”,而应作为单独的零容忍安全项;具体目标和处置时限由项目风险等级确定。
八、白泽经验与证据边界
白泽公开的污染源溯源智能体案例包含约9.5GB、1200多份异构资料,并把法规、历史报告、结构化检测数据和GIS工具放进同一证据链。它能证明多源资料治理、来源引用和确定性工具协同的工程经验;公开页面没有提供持续ACL同步、撤权时延或同步成功率数据,因此本文不把它包装成权限同步成绩。
可继续查看企业RAG开发服务了解检索、权限、引用和评测范围,也可核验污染源溯源智能体案例的公开证据。准备咨询时,建议带上资料源清单、用户与群组结构、更新频率、删除规则、典型问题和不可接受的越权场景。
白泽智能|重庆斯巴达信息技术有限公司
来源与适用边界
- Microsoft Graph:driveItem delta,核验日期:2026-11-04。
- Google Drive API:Retrieve changes,核验日期:2026-11-04。
- Google Drive API:Share files, folders, and drives,核验日期:2026-11-04。
- Atlassian Confluence Cloud:Content permissions,核验日期:2026-11-04。
以上材料用于核对增量游标、删除状态、权限继承和权限检查机制;具体接口权限、限额和字段可能随产品版本变化,实施前应重新核对目标租户与官方文档。本文给出的是工程方法,不代表厂商承诺、行业统一SLA或白泽既有项目成绩。