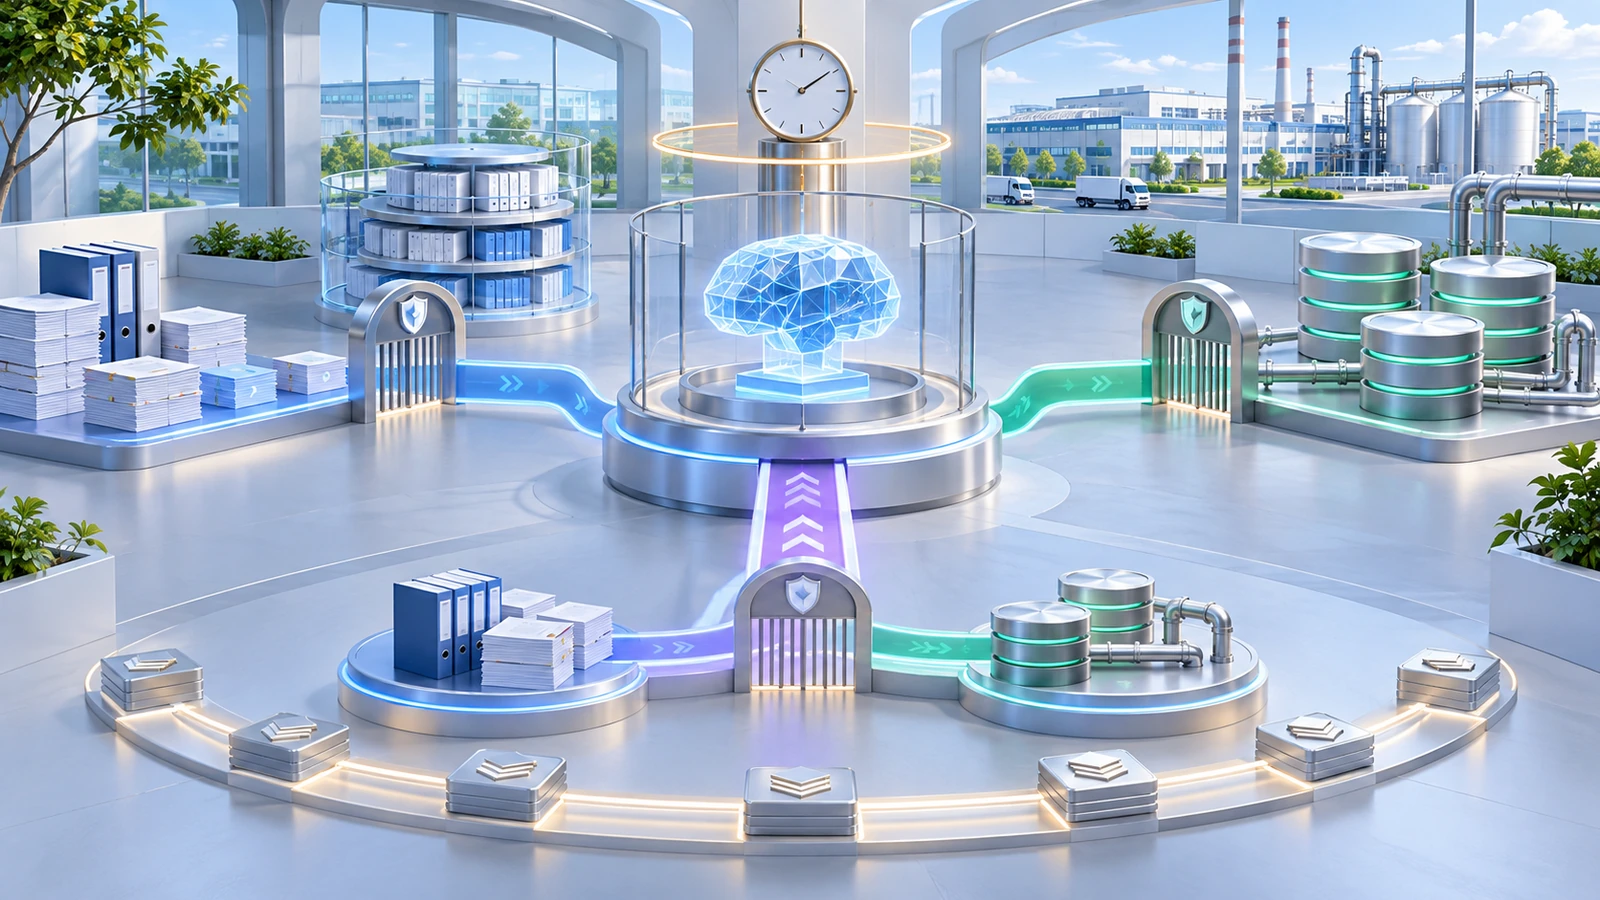
结论先说:企业知识库不必把所有业务数据复制到向量库。更合理的做法是按数据形态和决策时效,把静态文档入库、实时数据原位查询、混合检索分开设计。11月12日,Google Cloud在Data Cloud更新中把“无需搬移数据、按用户身份查询实时数据库、用语义模型解释业务口径”放进同一条链路。这并不意味着传统RAG过时,而是提醒企业:文档知识和实时经营数据不是同一种对象,应该用不同的数据路径和验收方法。
本轮先核验北京时间执行前24小时的一手材料,保留OpenAI、NVIDIA与Insight在11月13日发布的3条合格更新;为覆盖企业数据、模型与制造流程,扩展到48小时,再加入Google Cloud和Microsoft在11月12日的3条更新,共6条。未取得实时搜索量、热搜、站长查询或需求规模,不用厂商发布数量代替客户需求。
今日重点
- 智能体付款开始强调逐笔授权。 OpenAI 11月13日推出ChatGPT Wallet有限测试:智能体不接触真实卡号,每次购买要由用户安全确认,并留下授权记录。首期只覆盖美国部分Pro用户和美国发行卡。它说明高风险动作要把身份、授权、令牌和回执连成闭环,但不能写成中国企业现成可用的采购方案。
- 高风险知识问答仍需证据回指和人工确认。 NVIDIA 11月13日介绍Dyania Health在医院防火墙内处理病历,输出信号可追溯到原始记录,并由临床人员复核。文中7800多名患者是外部医疗研究口径;企业可借鉴“本地处理、证据回指、人工决策”的结构,不能照搬医疗效果。
- 智能体目录开始按业务任务交付。 Insight 11月13日发布Agent Store,列出报价、NDA审查、零部件订购等方案。公告中的14国覆盖、交付速度和内部采用率来自厂商自述;中国企业更需要核对数据驻留、系统接口、审批和持续运维,而不是只看方案数量。
- 实时企业数据可以原位查询。 Google Cloud 11月12日称,Gemini Data Cloud连接器进入预览,可连接BigQuery、Looker、Spanner、AlloyDB与Cloud SQL,按用户身份执行查询,并用Knowledge Catalog语义模型解释业务口径。已确认的是产品结构;未知的是本企业字段质量、查询成本、并发、尾延迟和故障表现。
- 新模型可用不等于现有业务应立即切换。 Gemini Enterprise发布记录显示Gemini 4 Hydrogen在Web、移动端、Workflow Builder和开发工具中正式可用;若企业维护自定义模型列表,仍需管理员选择。技术负责人应先跑任务回归,再决定是否替换生产模型。
- 规模化AI仍然要连接实时流程。 微软11月12日介绍其近500个项目经验,并把业务价值、流程重构、治理和成本列为共同条件;制造案例把实时数据、数字孪生与操作员建议连在一起。案例没有给出统一成本或周期,不能当成采购承诺。
重点拆解:三种数据路径不要混成一个知识库
企业常把“建设知识库”理解成收集文件、切片、向量化、检索。但客户真正提出的问题往往跨越三类数据:制度、手册、合同等相对稳定文档;库存、订单、设备状态等实时结构化数据;既要解释规则、又要读取当前状态的混合任务。如果全部复制进向量库,会产生更新延迟、权限漂移、数字聚合不准和重复存储;如果全部实时查库,又会让长文档引用、跨页证据和版本复现变得困难。
| 数据路径 | 适合对象 | 优点 | 主要风险 | 关键验收 | |---|---|---|---|---| | 静态文档入库 | 制度、手册、合同、报告、历史案例 | 可做语义检索、跨页引用、版本冻结 | 切片丢上下文、删除和权限同步滞后 | 引用定位、版本绑定、ACL同步、删除传播 | | 实时原位查询 | 库存、订单、设备、工单、经营指标 | 状态新、数字聚合更可靠、无需复制全量 | 语义映射错误、查询成本和尾延迟不可控 | 身份贯穿、SQL/工具审计、口径、P95/P99、只读边界 | | 混合检索 | “按制度判断当前订单”“结合手册分析设备报警” | 同时获得规则证据与实时状态 | 两条链的时间、身份和版本不一致 | 同一用户、同一时点、来源标识、冲突处理、最终回执 |
选择路径时先问四个问题:数据多久变化一次;答案是否必须精确到当前时点;用户权限能否贯穿到源系统;结果需要引用原文还是需要计算聚合。更新慢、重证据的文件适合入库;更新快、重精确数值的状态适合原位查询;需要规则解释加当前状态时采用混合架构。
为什么“全部向量化”容易出错
第一,向量库不是业务数据库。它擅长找语义相近片段,不保证库存求和、金额计算、时间窗口和事务状态准确。把订单表定期导出成文本再向量化,可能检索到相似订单,却无法可靠回答“当前可承诺库存是多少”。
第二,复制会产生时间差。源系统中数据被修改、删除或撤权后,副本何时同步决定了知识库是否继续暴露旧内容。验收不能只测首次导入,要测新增、修改、撤权、删除和恢复五种事件,并记录端到端传播时间。
第三,语义口径不会因为接上模型自动统一。“有效客户”“在制订单”“停机时间”往往在不同部门有不同定义。Google的更新把语义模型放在连接链中,说明自然语言查询之前仍需要业务词典、字段映射和认证口径。
第四,实时查询也有边界。连接器若使用超级账号执行,最终用户权限会在链路中丢失;复杂查询可能拖慢生产库;源系统断线时,模型可能把旧缓存当成实时结果。因此要设置只读副本、查询白名单、超时、限流、成本预算、缓存时间和失败默认行为。
一套可执行的架构选择方法
先为每类问题建立“数据需求卡”。至少记录主问题、决策时效、数据源、更新频率、权限事实源、需要的引用或计算、允许的最长延迟、失败时是否可以使用旧数据。没有这张卡,团队容易为了技术统一而把所有数据塞进同一索引。
然后做路径分配:
- 文档路径保留原文件、页码或段落定位、版本、权限、有效期和删除状态;切片只是检索副本,不能替代原始证据。
- 实时路径通过受控连接器或工具读取源系统,使用最终用户或明确授权的服务身份,限制可访问的数据集和查询动作。
- 混合路径先检索规则证据,再查询当前状态,最后由业务规则或受控Agent组合结果;输出必须分别标明文档版本、数据查询时间和来源。
- 写回路径与读取分离。知识库可以回答,不代表智能体可以改订单、发起采购或控制设备。写动作需要审批、幂等、参数校验、终态确认和回滚。
白泽的企业RAG与知识库开发服务可覆盖文档解析、权限过滤、实时数据工具、引用、评测与受控流程集成;污染源智能体案例展示了多来源信息与受控业务流程的公开实践。案例不代表已实测本文所述Google预览功能,也不把外部厂商指标当作白泽项目成绩。
怎么验收实时数据知识库
验收集必须同时包含文档题、实时时点题和混合题。每道题保存期望来源、允许数据时点、角色、预期拒绝条件和计算口径。建议至少覆盖:
- 同一问题在数据更新前后得到不同、且可解释的答案;
- 有权、部分有权、无权和刚撤权角色的结果符合源系统权限;
- 文档版本与实时查询时间在答案中可追溯;
- 源系统超时、语义服务不可用、字段变更和连接器断线时保守失败;
- 查询只读、限流和成本预算有效,不影响生产系统;
- 数字聚合可由SQL或确定性工具复算,不让模型心算关键金额与数量;
- 写动作必须经过审批,并保存请求、参数、执行终态和回滚回执。
准确率不能只用“回答看起来对”衡量。文档题看引用正确率和版本一致性;实时时点题看数值正确率、数据新鲜度与查询成功率;混合题看规则版本、数据时间和结论是否一致;权限题看越权召回率必须为零,并单独统计误拒绝。
适用条件与风险
这套方法适合同时拥有文档、数据库和业务系统的企业知识库、经营问答、设备助手、售前报价助手和合规Agent。若源系统没有稳定接口、字段含义不统一、权限只靠人工约定或生产库不能承受查询,应先做数据治理和只读服务,不宜直接承诺实时问答。
主要风险包括:副本长期不同步;用户身份在连接器中丢失;自然语言被翻译成高成本或越权查询;业务词典漂移;缓存没有标注时间;源系统异常时输出旧数据;模型升级改变工具选择;写回动作缺少终态确认。对应措施是数据需求卡、分路径架构、用户身份贯穿、只读与限流、语义版本、时间戳、故障默认拒绝和固定回归集。
今日企业行动
- 从现有知识库抽取20个真实问题,标记它们属于静态文档、实时数据还是混合任务,停止用一个索引解决全部问题。
- 为两道实时问题建立数据需求卡,写清数据源、角色、更新时间、允许延迟、查询口径和断线时的默认行为。
- 用同一道混合问题测试有权、无权和刚撤权角色,保存文档版本、查询时间、SQL或工具调用、引用与最终回执。
准备咨询时,可提供脱敏文档样本、数据库或API清单、字段词典、角色矩阵、更新频率、实时问题、允许延迟、查询并发、写回动作和现有审计要求。白泽智能|重庆斯巴达信息技术有限公司。
来源与证据边界
- OpenAI:ChatGPT Wallet(2026-11-13)
- NVIDIA:医疗记录AI与证据回指案例(2026-11-13)
- Insight:Agent Store(2026-11-13)
- Google Cloud:Data Cloud更新(2026-11-12)
- Google Cloud:Gemini Enterprise发布记录(2026-11-12)
- Microsoft:从AI愿景到业务影响(2026-11-12)
厂商产品、预览功能、案例和内部采用数据只按公开范围陈述,不作为白泽项目成绩、搜索排名、询盘数量、固定节省或实施周期承诺。