结论先说:企业知识库接入更多数据源、项目和智能体之前,先统一身份、权限、策略和审计边界。11月10日至11日,Google Cloud连续更新跨项目与跨云智能体治理、受控数据连接和Agent Gateway;NVIDIA同时强调跨部署环境的智能体治理。它们共同指向一个采购问题:RAG和Agent是否可用,不只看答案质量,还要证明谁以什么身份访问哪份知识、调用哪个工具、策略在哪里执行、结果如何追溯和回退。
本轮优先核验北京时间执行前24小时的一手材料,不足部分扩展至48小时,并补充11月9日采购渠道变化。最终保留8条合格更新,覆盖企业知识库、智能体治理、跨云运行、标准连接器、行业编排和采购。未取得实时搜索量、热搜或站长查询,不用厂商发布数量代替客户需求。
今日重点
- 跨云智能体治理进入受限预览。 Google Cloud 11月11日说明Agent Gateway可治理任何CNCF兼容Kubernetes集群上的智能体。已确认的是产品方向和准入方式;未知的是不同本地集群、网络与身份系统的实际兼容成本。平台负责人应关注策略执行点和身份贯通,而不是只看“跨云”标签。
- 跨项目政策可由中心项目统一执行。 11月10日更新支持中心项目发现成员项目中的智能体,并保留运行身份,再由单一Gateway与语义策略引擎集中施策。它适合多部门、多项目场景,但不能替代企业自己的项目边界、例外审批和拒绝回执。
- 受控目录开始承接企业数据连接。 Gemini Enterprise支持把Workspace和第三方联邦数据源连接到Assured Workloads目录内的项目。官方强调自动施加安全与合规控制;企业仍要核对连接器字段、权限同步频率、删除传播、地域和审计范围。
- 标准连接器降低接入门槛,也扩大权限面。 Google Cloud列出MCP、A2A与REST等连接方式,并把认证和多步工具执行列为主要工程阻力。接口标准化不等于权限正确,知识库必须把调用身份、工具白名单、参数约束和失败回退纳入验收。
- 商家信息与业务智能体进入ChatGPT测试版。 OpenAI推出Businesses in ChatGPT,允许企业认领和维护信息,并先向美国部分电商与在线服务企业提供Business Agents。企业要区分信息管理、用户互动、搜索曝光与实际转化,不能把测试版受理当成排名或询盘。
- 开源智能体运行时强调隔离与恢复。 NVIDIA宣布向CNCF沙箱捐赠OpenShell,并说明可在不同部署环境应用治理。企业应验证策略是否在运行时真正阻止越权,以及检查点、网络隔离和回滚是否可复现。
- 行业方案继续强调“证据加人工监督”。 Google Cloud医疗方案把碎片化记录、理赔和临床证据放入受治理编排层,并要求可核验证据和人工监督。这个方法可迁移到企业知识库,但医疗成效和合规不能外推其他行业。
- 采购渠道变简单,不代表上线完成。 ChatGPT Enterprise进入AWS Marketplace,可沿用既有AWS采购和账单关系。采购、技术集成、数据治理、验收和发布是不同状态,企业仍需分别留证。
重点拆解:为什么先统一权限边界
传统知识库常把权限理解为“登录后能不能看到某个文件夹”。RAG和Agent把问题放大了:检索服务可能用应用账号读取数据,模型可能在一次回答中组合多个来源,智能体还会调用搜索、工单、数据库或执行工具。如果用户身份在链路中丢失,即使每个单点系统都设置了ACL,最终仍可能出现越权引用、过期权限缓存、跨项目数据混用和无法定位责任主体。
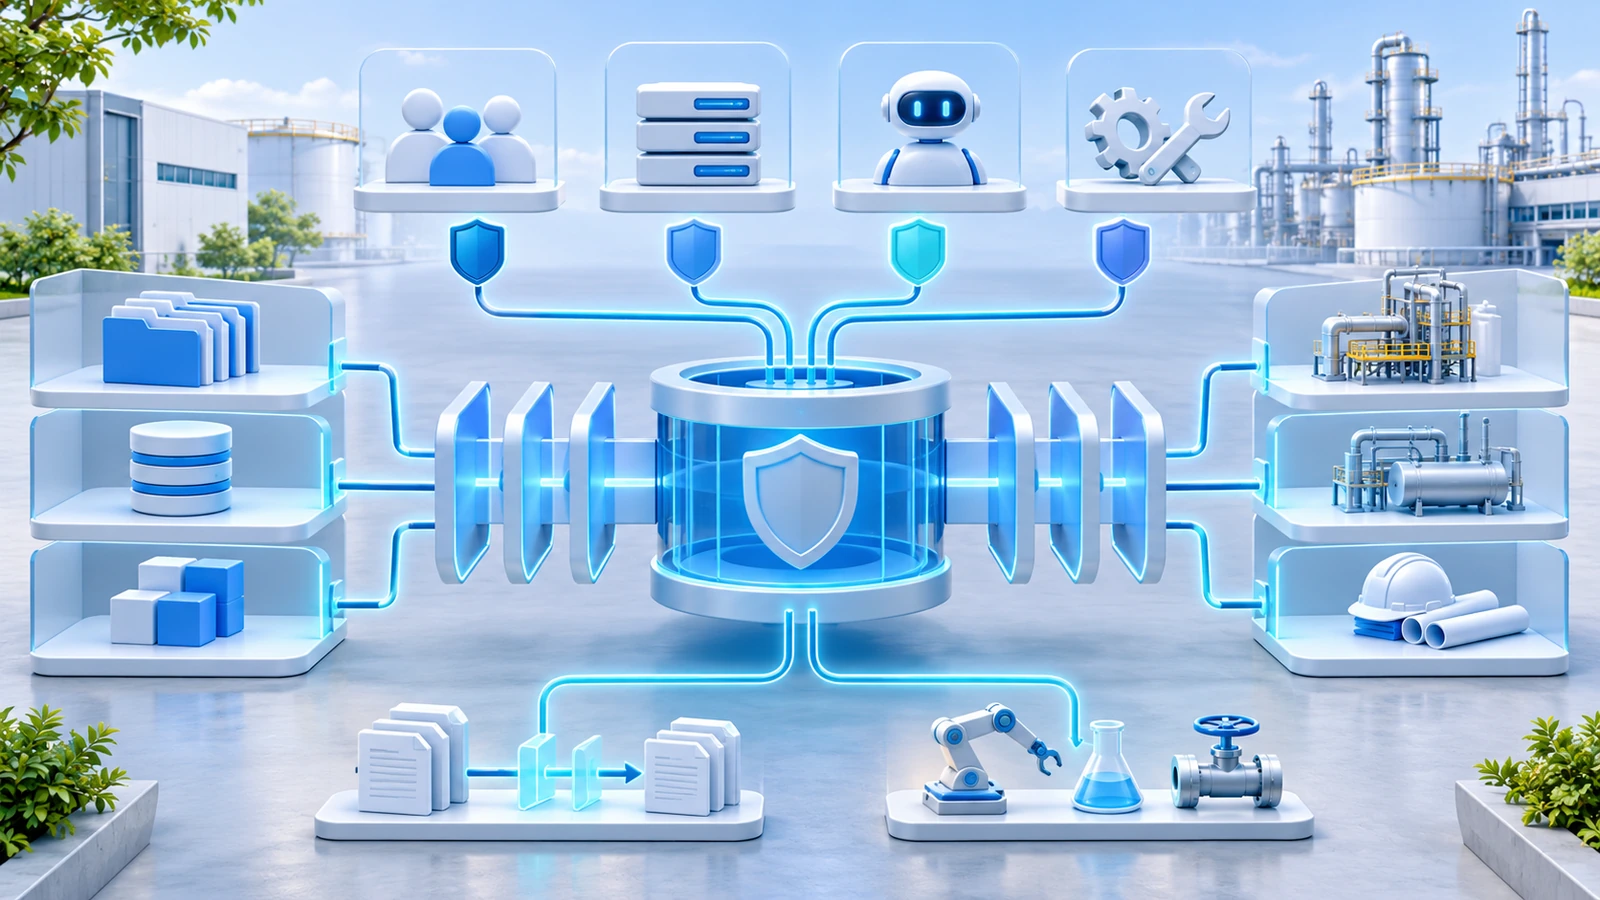
因此,权限治理不应只存在于数据源入口,而要贯穿五个控制面:
| 控制面 | 必须回答的问题 | 验收证据 | |---|---|---| | 身份 | 最终用户、应用账号与智能体运行身份如何绑定 | 身份映射、令牌受众、会话主体、代理链 | | 数据 | 哪些文档、字段、版本和标签允许被检索 | ACL快照、过滤条件、权限同步时间、拒绝记录 | | 工具 | 哪个角色可调用哪个工具与参数 | 工具白名单、参数约束、审批与最小权限 | | 策略 | 政策在入口、Gateway还是运行时执行 | 策略版本、命中日志、例外审批、策略失败模式 | | 审计 | 一次答案或动作如何回到证据与责任主体 | 引用、调用链、输入输出摘要、终态与回滚记录 |
跨项目和跨云治理的价值,不是把所有系统放进一个大权限池,而是把政策定义、身份发现和审计格式尽量统一,同时保留项目、部门与环境隔离。中心平台可以分发政策,但每个数据源仍应是权限事实源;中心注册表可以发现智能体,但不能自动假定它们拥有相同信任等级。
企业知识库如何落地统一治理
第一步,画出身份与数据流。把最终用户、企业身份提供商、RAG服务账号、智能体运行身份、数据源账号和工具账号放在一张图上,标出令牌在哪里交换、权限在哪里缓存、引用在哪里生成。如果无法回答“这段答案以谁的身份读取”,就不应进入生产。
第二步,确定权限事实源与同步SLA。文件系统、协作平台、数据库和业务系统可能各自管理权限。知识库应记录来源ACL、同步时间和版本;人员转岗、离职、文档撤权或空间迁移后,多久必须停止召回。可先设置分钟级或小时级目标做试验,但它只是项目假设,不是统一行业标准。
第三步,建立拒绝优先的检索链。权限过滤应尽量在检索前执行,不能让无权内容先进入模型上下文再靠提示词隐藏。对权限不明、同步超时、来源失联和策略引擎异常,默认拒绝或降级到获准公共知识,并向用户说明原因。
第四步,分离读、写与执行权限。能搜索知识不等于能修改知识,能生成工单建议也不等于能提交工单。Agent工具应按动作风险分层:只读查询可自动执行;写入、外发、费用、设备与账号动作需要更严格的参数限制、审批、幂等和回滚。
第五步,用“同题不同身份”验收。为同一问题准备至少三类角色:有权、部分有权、无权;再加入权限刚变更、旧缓存、跨项目同名文档、过期版本和来源失联。验收既看回答正确,也看无权时是否拒绝、引用是否消失、审计日志能否解释决策。
第六步,保留政策版本与回归集。数据源、连接器、模型、提示、Gateway或策略规则变化后,重复跑相同权限回归集。若策略只在一个环境验证,跨云和本地部署仍应分别复测网络、身份、时间同步、日志与故障模式。
白泽的重庆RAG开发服务覆盖数据连接、权限过滤、引用和评测;侧重组织知识管理可查看企业知识库建设。公开的污染源智能体案例可用于理解多来源证据与受控流程,但它不是本轮Google或NVIDIA产品的实测,也不代表已验证跨云Agent Gateway。
选型与验收边界
选择集中治理平台时,先核对它能否发现既有智能体、保留原运行身份、统一策略格式并把拒绝原因写入日志;选择联邦数据连接时,核对字段级权限、删除传播、地域、密钥、缓存和断线行为;选择开源运行时时,核对隔离强度、网络出口、检查点恢复和升级责任。
主要风险包括:应用账号绕过最终用户权限;权限同步延迟导致撤权后仍可检索;同名文档跨项目混用;工具参数越界;Gateway故障时默认放行;审计只记录模型文本而缺少数据与工具证据;集中平台成为单点故障;把供应商合规描述误当成本企业认证。对应措施是最小权限、拒绝优先、分层执行、策略版本化、故障演练和独立审计。
今日企业行动
- 选一个现有知识库流程,画出最终用户、RAG服务、数据源与工具账号的身份链,标记权限判断和缓存位置。
- 建立10至20项“同题不同身份”小型回归集,覆盖撤权、跨项目同名文档、旧版本、来源失联和工具拒绝。
- 要求候选方案现场演示策略失败、权限变更和回滚,并导出引用、策略命中、工具调用与终态证据。
准备咨询时,可提供脱敏的数据源清单、角色矩阵、权限变更SLA、项目与部门边界、工具动作清单、审批规则、审计保留期和故障降级要求。白泽智能|重庆斯巴达信息技术有限公司。
来源与证据边界
- Google Cloud:Gemini Enterprise Agent Platform更新(2026-11-10至11)
- Google Cloud:Gemini Enterprise数据连接与版本更新(2026-11-10)
- Google Cloud:Gemini factory与标准连接器(2026-11-10)
- OpenAI:Businesses in ChatGPT测试版(2026-11-10)
- NVIDIA:OpenShell与跨环境治理(2026-11-10)
- Google Cloud:Gemini for healthcare(2026-11-10)
- Google Cloud:Kubernetes开放AI技术栈(2026-11-10)
- OpenAI:ChatGPT Enterprise进入AWS Marketplace(2026-11-09)
厂商功能、预览状态、合作计划和行业方案只按官方范围陈述,不作为白泽项目成绩、合规认证、成本节省、搜索排名或上线承诺。未取得实时搜索量、热搜、站长查询或需求规模。