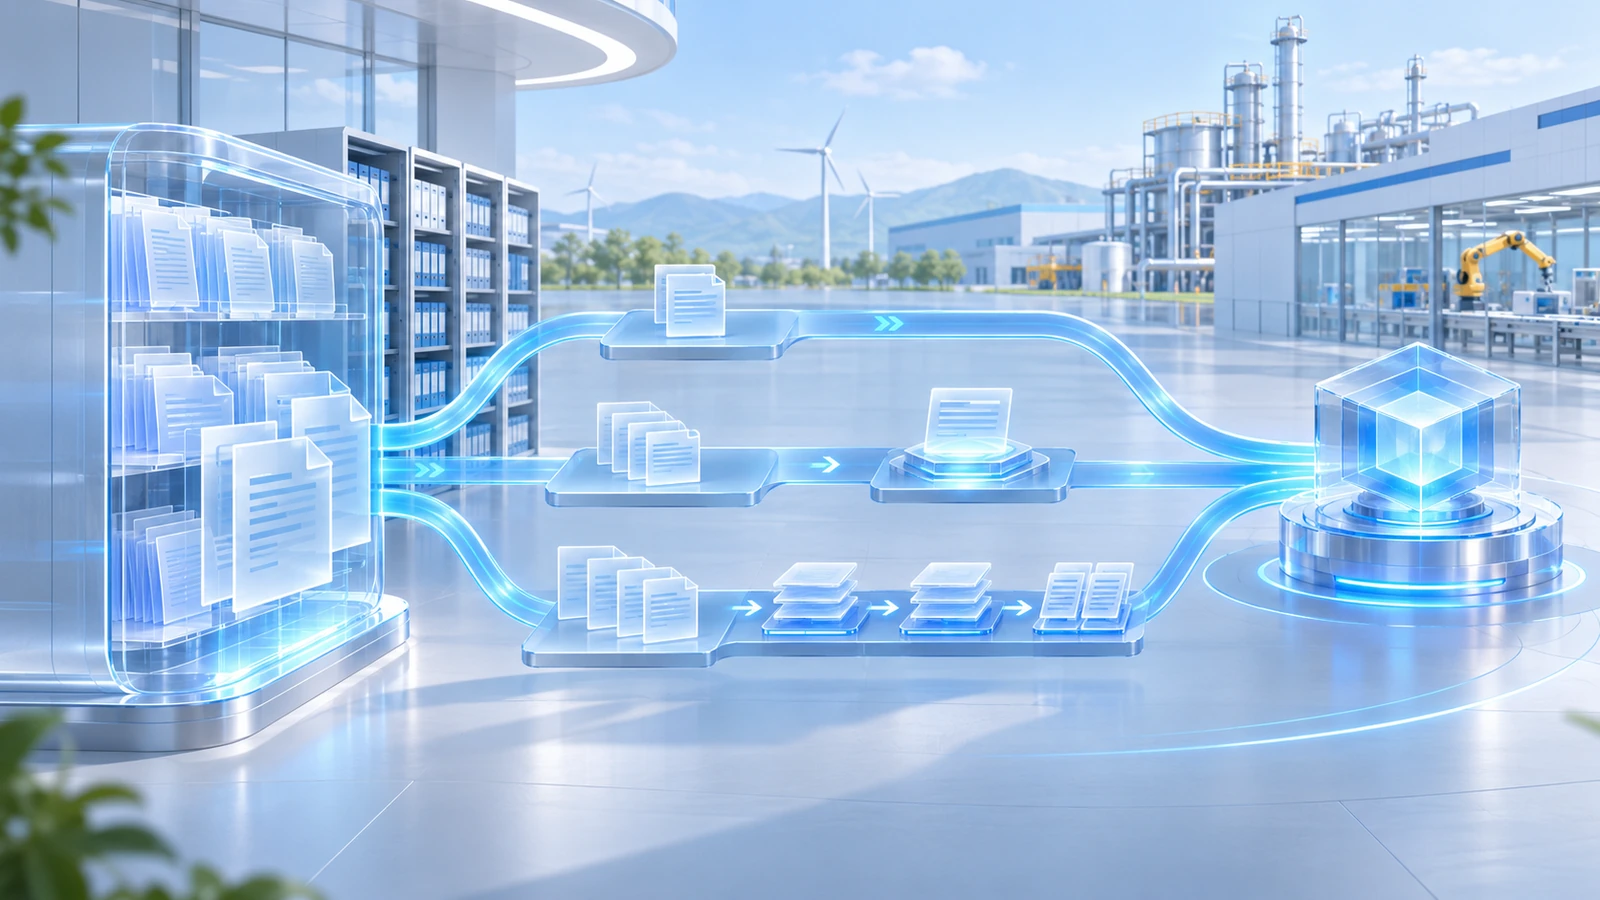
结论先说:企业知识库不应让每个问题都走同一条RAG链路。制度原文查看、单一清单查询和跨多份文件比较,所需的检索深度、生成成本、证据要求与风险完全不同。11月9日,AWS为托管知识库公开三种可通过同一接口调用的模式:只返回来源片段、一次检索后生成、以及多轮规划检索后生成。真正值得企业采用的不是某个参数,而是按问题复杂度分档,并用同一组代表性问题验证证据、权限、延迟与成本。
本轮先核验北京时间执行前24小时的一手材料,必要时扩展到48小时。最终保留2026年11月8日至9日的7条合格更新,覆盖企业知识库、Agent运行时、机器人仿真、物理AI、分布式推理、安全运行时与异构芯片。研究窗口内跨厂商合格更新有限,因此没有用旧闻、媒体转述或工具热度凑到8条;搜索量、热搜和站长实时查询均未取得。
今日重点
- 企业知识库新增三档检索模式。 AWS的`AgenticRetrieveStream`可在同一接口下返回来源片段、完成单次RAG,或执行多轮代理检索。已核验的是服务参数与示例;未知的是它在企业现有文档、中文问题和权限体系上的实际正确率。知识库负责人应关注如何路由,而不是默认多轮越多越好。
- 路由不会自动替企业做决定。 AWS明确说明,`maxAgentIteration`只控制迭代上限,选择哪种模式仍是应用逻辑。直接问题可从低迭代开始,复杂比较才增加规划;采购和验收团队需要先定义问题类型、失败代价与升级条件。
- Agent运行时继续优化冷启动与内存。 AWS周报称Runtime V2按需扩展并回收内存,通过快照恢复环境;厂商测试的P75冷启动约2秒,但同时说明单价更高、降本并不保证。企业应以自有镜像、峰值并发和会话长度复测,不能把厂商数字直接写进SLA。
- 机器人训练把仿真推进到精细操作。 NVIDIA在CoRL介绍GR00T 2、Isaac Lab 3.0、开放基准和代理式机器人工作流,重点从移动扩展到齿轮对齐、接线和小件装配。制造企业需要关注失败样本如何回到仿真与训练,而不是把研究演示当成可投产精度。
- 物理AI数据飞轮出现更完整的公开链路。 NVIDIA与LG披露的CLOiD流程把真实数据、合成增强、模型训练、端侧计算和仿真评估串联起来。它说明机器人项目要同时管理数据、仿真和现场验证;合作披露没有给出可通用的节拍或安全成绩。
- 开放模型部署开始交付多节点配方。 NVIDIA为四个韩国开放模型发布Dynamo优化配方,面向B200多节点推理并报告最高2倍性能。数字只适用于指定模型与平台;私有化项目仍应按并发、上下文、答案质量、功耗和故障恢复验收。
- Agent安全与异构推理都在强调边界。 OpenShell把沙箱和策略控制放进运行时;NVLink Fusion合作则计划让GPU处理prefill、NPU处理decode。前者仍需验证权限和数据泄露防护,后者预计系统尚未交付,都不能替代当前项目的本地验证。
重点拆解:为什么知识库要按问题分档
“员工问什么,都先让Agent拆问题、改写查询、反复搜索,再生成答案”听起来能力更强,实际可能把简单查询变慢、变贵,也扩大无答案时的生成空间。反过来,如果所有问题都只检索一次,跨制度、跨部门或带条件比较的问题又可能漏掉关键证据。
AWS公开的新模式提供了一个清晰参照:`maxAgentIteration=0`时只执行检索,不调用大模型生成;`=1`时做一次检索并生成一个有依据的回答;`=2`至`5`时允许多轮规划和补充检索,最后再生成。每个迭代对应一次基础模型调用,最后一次预留给答案生成。这里最重要的边界是:参数不会自动判断问题难度,路由必须由企业应用自己完成。
企业可以先用三档业务规则,而不是一开始训练复杂路由模型:
| 问题档位 | 典型问题 | 建议路径 | 必须保留的证据 | |---|---|---|---| | 来源核对 | “把最新报销制度原文给我” | 仅检索,不生成 | 文档版本、权限、片段、页码或定位信息 | | 直接回答 | “差旅住宿上限是多少” | 一次检索加一次生成 | 命中片段、引用、答案与文档生效日期 | | 复杂比较 | “不同职级、城市和出差天数的规则有何差异” | 多轮规划检索 | 子问题、每轮检索、缺口、引用与最终组合逻辑 | | 无答案或高风险 | “帮我批准例外费用” | 拒答或转人工,不以检索深度替代权限 | 无答案原因、审批人、业务系统回执 |
分档不是按句子长短。一个很短的问题也可能高风险,例如“这个供应商能付款吗”;一个很长的问题也可能只需返回原文。更可靠的路由特征包括:是否要求原文、是否跨多份制度、是否需要比较或计算、是否涉及权限与个人数据、答案错误会不会触发付款或生产动作,以及当前检索是否已获得足够证据。
如何把路由策略做成可验收系统
第一步不是调参数,而是建立代表性问题集。至少覆盖直接查找、跨文档比较、时间条件、冲突条款、权限差异、同义表达、错别字、表格与附件,以及文档中根本没有答案的问题。每道题要有可核对的参考证据、允许看到该证据的角色,以及错误答案的业务后果。
第二步让三种路径在同一问题集上对比。不要只看“回答像不像”,至少记录:证据是否正确、引用是否能打开、权限是否一致、无答案时是否明确停下、P50与P95延迟、每问模型调用次数、检索次数和人工复核量。成本计算应使用企业自己的调用单价与流量分布;本文不提供没有公开依据的固定节省比例。
第三步定义升级和降级条件。例如:单次检索只命中一个低相关片段、问题含比较词且涉及多个对象、或来源间存在冲突时,可升级到多轮检索;若权限不足、无高于阈值的证据、问题要求执行高风险动作,则不应继续“多搜几次碰答案”,而应拒答或转人工。系统还要保存路由原因、参数版本和每轮证据,才能复盘为什么某个问题变慢或答错。
第四步把生成和业务动作分开。多轮检索可以提高证据覆盖,但不代表有权审批、修改主数据或控制设备。涉及付款、合同、停机、人员与合规的动作,仍要经过确定性权限、业务规则、人工审批和目标系统回执。知识库给出的应是可追溯证据,不是越权许可。
白泽的重庆RAG开发服务覆盖文档解析、检索、权限、引用与评测;知识管理场景也可查看企业知识库建设。公开的污染源智能体案例可用于理解多来源证据和受控流程,但它不代表已实测AWS本次参数,也不提供未公开的成本、准确率或客户配置。
适用条件与风险
问题分档适合文档规模较大、问题难度差异明显、直接查询占比高、又存在跨制度比较的企业知识库。若文档很少、问法固定,简单检索加明确模板可能更经济;若数据权限尚未同步、文档版本混乱或引用无法定位,先治理内容与权限,比增加代理检索更重要。
主要风险包括:路由器把复杂问题误判为简单查询;多轮检索重复同一证据却增加成本;权限在子查询中丢失;过期文档被多轮放大;无答案问题经过多轮后生成看似完整的结论;监控只记录最终文本,没有每轮检索和版本;高风险问题被当作知识问答而非业务动作。每项都需要保守默认、人工升级和可回滚配置。
今日企业行动
- 从真实业务中各选20道原文查看、直接回答、复杂比较和无答案问题,冻结文档版本、角色权限与参考证据。
- 用同一问题集比较仅检索、单次RAG和多轮检索,记录证据正确率、引用可用率、权限泄漏、P95延迟、模型调用数与人工复核量。
- 先写确定性升级规则:跨文档比较才加深检索;权限不足、无证据或要求高风险执行时立即拒答或转人工,不用更多迭代掩盖边界。
准备咨询时,可提供脱敏文档目录、文档数量与格式、权限角色、20至50道代表性问题、期望引用形式、无答案处理、并发与延迟目标,以及需要连接的业务系统。白泽智能|重庆斯巴达信息技术有限公司。
来源与证据边界
- AWS:托管知识库的单次与代理检索(2026-11-09)
- AWS:AgentCore Runtime V2周报(2026-11-09)
- NVIDIA:CoRL机器人仿真与开放基准(2026-11-09)
- NVIDIA:韩国物理AI产业应用(2026-11-08)
- NVIDIA:Dynamo开放模型部署配方(2026-11-08)
- NVIDIA:Agent安全运行时合作(2026-11-08)
- NVIDIA:NVLink Fusion异构推理合作(2026-11-08)
厂商测试、研究演示、合作计划和未来时间表只按原始适用范围陈述,不作为白泽项目成绩、采购收益或上线承诺。未取得实时搜索量、热搜、站长查询或需求规模。